Cerchi «rilevatore IA» e ne trovi dieci, tutti gratuiti, tutti sicuri di sé. Incolli un testo e ottieni una percentuale. Quella percentuale non dice chi ha scritto il testo: dice quanto quel testo somiglia allo stile che il rilevatore considera «da macchina». Sono due cose diverse, e la differenza ha conseguenze concrete — su studenti, traduttori e chi scrive di mestiere.
Qui trovi come funzionano davvero questi strumenti, i numeri misurati da chi li ha testati, perché sbagliano e cosa si può fare al loro posto. C’è anche la parte che serve a chi è stato accusato ingiustamente, che è più frequente di quanto si pensi.
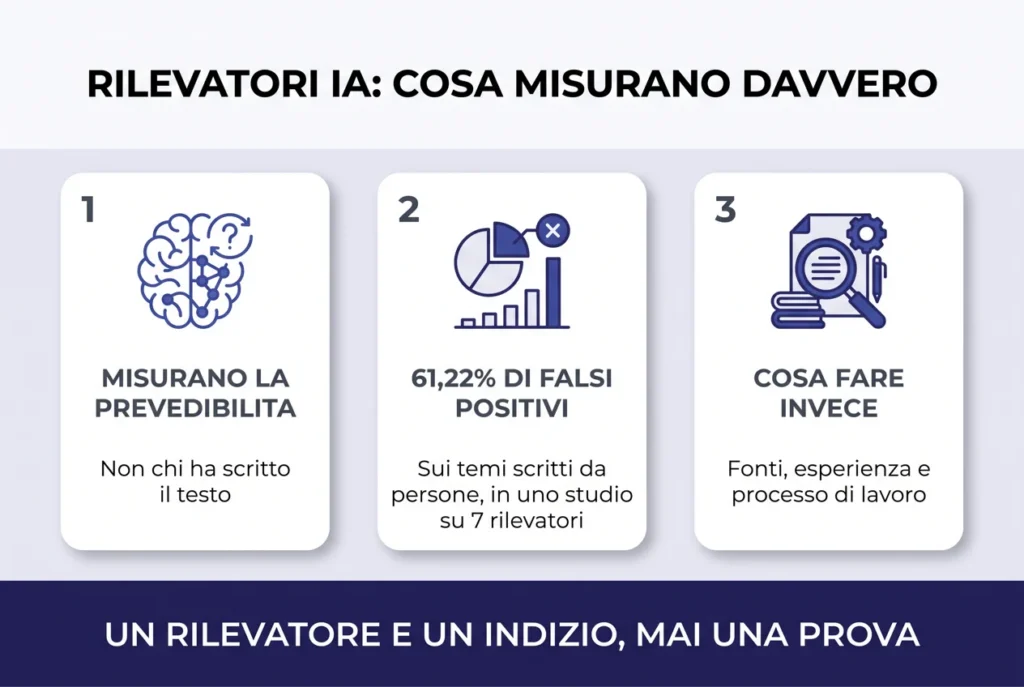
In una frase: i rilevatori di testo IA non sono affidabili e i numeri lo dimostrano — in uno studio del 2023 su sette rilevatori, il 61,22% dei temi scritti da persone (studenti non madrelingua inglese) è stato classificato come «generato dall’IA». Il classificatore di testo AI di OpenAI individuava come generato solo il 26% dei testi scritti dall’IA e segnalava il 9% dei testi umani; è stato ritirato il 20 luglio 2023 per la bassa accuratezza. Al posto del rilevatore servono le fonti e le prove: la sostanza, non lo stile.
Come funziona un rilevatore IA?
Un rilevatore non confronta il testo con un archivio di testi generati: misura quanto il testo è prevedibile. Calcola cioè quanto le parole che hai scritto fossero probabili dopo le precedenti — è la stessa cosa che fa un modello linguistico quando scrive, usata al contrario. Un testo molto regolare, con frasi di lunghezza simile e parole ricorrenti, risulta «probabile» e viene segnato come generato. Un testo irregolare, con frasi rotte e scelte sorprendenti, risulta «improbabile» e viene segnato come umano.
Il punto è tutto qui: sta misurando una proprietà dello stile, non l’origine del testo. Uno studente che scrive in modo semplice e regolare produce un testo «probabile». Un articolo tradotto dall’inglese con un traduttore automatico produce un testo «probabile». Un verbale, una relazione tecnica, un testo normativo: tutti «probabili». Nessuno dei quattro è stato scritto da un’IA — e tutti e quattro rischiano di essere segnalati.
Quanti falsi positivi fanno i rilevatori?
Non è un’opinione. Nel 2023 un gruppo di ricerca dell’Università di Stanford — Liang, Yuksekgonul, Mao, Wu e Zou — ha testato sette rilevatori pubblici su due insiemi di testi: saggi di studenti statunitensi e temi di inglese sostenuti da studenti non madrelingua (i test TOEFL). Il risultato è pubblicato come articolo accademico ed è brutale: i sette rilevatori hanno classificato come «generati dall’IA» il 61,22% dei temi scritti da persone.
I rilevatori hanno classificato male più della metà dei temi TOEFL come «generati dall’IA» (tasso medio di falsi positivi: 61,22%). Tutti e sette i rilevatori hanno identificato all’unanimità 18 dei 91 temi TOEFL come generati dall’IA.
Liang, Yuksekgunul, Mao, Wu, Zou — «GPT detectors are biased against non-native English writers», 2023
C’è un secondo numero, che riguarda lo strumento invece delle persone. Il classificatore di testo AI di OpenAI, pubblicato a gennaio 2023, individuava come «probabilmente scritto dall’IA» solo il 26% dei testi generati, e segnalava come generato il 9% dei testi scritti da persone. OpenAI lo ha ritirato il 20 luglio 2023 proprio per la bassa accuratezza. Vale la pena ripeterlo: l’azienda che produce i modelli ha spento il proprio rilevatore.
| Chi misura | Cosa ha misurato | Risultato |
|---|---|---|
| Stanford, 7 rilevatori (2023) | Temi di inglese di studenti non madrelingua (TOEFL) | 61,22% classificati come generati dall’IA |
| Stanford, 7 rilevatori (2023) | Stessa prova, voti unanimi dei sette | 18 su 91 temi segnalati da tutti e sette |
| OpenAI, classificatore proprio | Testi scritti dall’IA riconosciuti | 26% (poi ritirato) |
| OpenAI, classificatore proprio | Testi umani segnalati come IA | 9% |
Anche i classici finiscono nel mirino
C’è un effetto collaterale che rende il problema evidente a chiunque ci giochi cinque minuti: se il rilevatore misura la prevedibilità, allora i testi molto regolari e molto canonici risultano «da macchina» — compresi quelli scritti prima che l’IA generativa esistesse. È la prima cosa che raccontano gli scrittori quando se ne parla. In una discussione su r/writers, un utente lo mette così:
La sfortunata realtà è che non puoi riconoscerlo — e probabilmente è meglio così, perché non vogliamo una sorta di «paura rossa» in cui gli autori cominciano ad accusare altri autori che non gli piacciono di usare l’IA. I rilevatori sono in gran parte screditati: valutano i classici — e persino cose che hai scritto tu — come se contenessero molto testo IA, anche testi scritti molto prima che l’IA esistesse.
u/drewhead118, r/writers
L’altra cosa che si legge nella stessa discussione è più difficile da accettare: il danno arriva prima della prova. Un altro utente racconta di essere stato accusato di usare l’IA «pur non usandola affatto per scrivere» — scrive, dice, in modo molto formale, ed è questo a farlo sembrare una macchina. È il meccanismo descritto dallo studio di Stanford, applicato a una persona invece che a un campione.
L’effetto non è solo digitale. Il Post, in un articolo del 30 marzo 2026, ricostruisce il caso di un romanzo ritirato dal mercato da un grande editore statunitense dopo le accuse dei lettori — e spiega che, in generale, «non esistono metodi né strumenti per riconoscere con certezza» un testo generato, con «tutti i rischi che ne conseguono per la reputazione di chi è accusato ingiustamente» (l’articolo completo è qui).
Perché i rilevatori sbagliano?
- Misurano lo stile, non l’origine. Un testo formale, tradotto o molto regolare è «probabile» per costruzione: non c’è nessuna proprietà intrinseca del testo che dica chi l’ha scritto.
- Sui testi brevi non hanno segnale. Su poche centinaia di parole non c’è abbastanza materiale per stimare una regolarità: il risultato è rumore, presentato con l’aria di una misura.
- Il campione di riferimento è inglese. Ed è la ragione per cui lo studio di Stanford trova il 61% sui temi di studenti non madrelingua: chi scrive in un inglese semplice e lineare — perché lo sta imparando — somiglia di più al «testo probabile» di chi scrive in inglese da madrelingua.
Su questo punto l’articolo di Il Post aggiunge l’elenco degli indizi che circolano — elenchi di tre punti, trattino lungo, cliché ripetuti — e la conclusione è la stessa: sono indizi, non prove, e riguardano lo stile. Chi scrive male, chi traduce, chi usa un registro formale può esibire tutti quegli indizi senza aver usato nessuna IA.
E in italiano? Cosa si può dire (e cosa no)
Vale la pena dirlo perché è la domanda che arriva subito: i rilevatori più diffusi — Copyleaks, ZeroGPT, Pangram — nascono e sono tarati principalmente sull’inglese, ed è quella la lingua su cui sono state misurate le accuratezze. Esistono strumenti dichiaratamente per l’italiano: il più citato nelle guide in italiano è isgen.ai. Ma le tre ragioni del capitolo precedente non dipendono dalla lingua: un testo tradotto, un testo breve e un testo molto formale restano «probabili» anche in italiano.
Quello che non posso dirti è una percentuale di errore per l’italiano: nessuno degli studi che ho trovato misura i rilevatori su testi italiani con la stessa metodologia di Stanford. È un dato che manca, e chi promette numeri precisi sull’italiano sta inventando. La conclusione prudente è quella che vale ovunque: un rilevatore è un indizio, mai una prova.
C’è anche un equivoco da chiarire, perché riguarda gli strumenti che molta gente usa: i cosiddetti «umanizzatori», cioè i programmi che riscrivono un testo per farlo passare come umano. Funzionano al contrario di un rilevatore — cambiano le parole più prevedibili in parole meno prevedibili — e hanno due difetti che vale la pena sapere. Il primo: non aggiungono nessuna informazione, quindi non rendono il testo più vero. Il secondo: rendono il testo peggiore, perché per abbassare la «prevedibilità» spesso sostituiscono parole semplici con sinonimi meno precisi. Se un testo va riscritto, la ragione utile è che era scritto male, non che somigliava a una macchina.
Cosa fare invece del rilevatore
Se il problema è «questo testo è affidabile?», il rilevatore risponde alla domanda sbagliata. Le quattro mosse che funzionano sono altre, e riguardano la sostanza.
- Chiedi le fonti delle affermazioni verificabili e aprirle una per una. È il controllo che smaschera davvero il testo generato, perché il modello inventa le fonti prima ancora che lo stile lo tradisca. Il metodo passo per passo è nella guida a ChatGPT per principianti, e il vocabolario di base è nella guida AI per principianti.
- Cerca l’esperienza, non lo stile. Chi ha fatto una cosa la racconta con dettagli che non si inventano: una misura, un errore, una data. È la stessa cosa che i motori di ricerca premiano da anni (esperienza, competenza, autorevolezza, affidabilità).
- Guarda il processo, non il prodotto. Cronologia delle versioni, appunti, bozze: sono la prova di come un testo è nato, e li ha solo chi l’ha scritto.
- Non usare un rilevatore come arbitro. Se la posta in gioco è un voto, un incarico o una reputazione, uno strumento con il 61% di falsi positivi su un gruppo di persone non è una prova: è un rischio.
Se sei tu quello accusato
È il capitolo che serve a chi cerca «rilevatore IA» per difendersi. Tre cose, in ordine. La prima: non rispondere con la percentuale di un altro rilevatore — la stai trattando come una prova, e nel momento in cui la usi accetti il suo quadro. La seconda: porta il processo, cioè quello che hai e che l’accusatore non ha: la cronologia del documento, gli appunti, le versioni precedenti, i file di lavoro. La terza: cita il dato, perché è pubblico e verificabile: uno studio su sette rilevatori ha misurato il 61,22% di falsi positivi su testi scritti da persone, e la stessa azienda che produce i modelli ha ritirato il proprio rilevatore per bassa accuratezza.
Se il dubbio riguarda invece cosa fa un modello quando scrive — e perché il testo risulta «probabile» — la differenza fra IA generativa e IA analitica chiarisce il meccanismo; e se stai cercando uno strumento da usare, il confronto è in migliori strumenti AI gratuiti.
Un’ultima informazione utile, che riguarda il futuro prossimo: dal 2 agosto 2026 l’articolo 50 dell’AI Act europeo impone ai fornitori di marcare in modo leggibile dalle macchine i contenuti generati o manipolati, con una proroga al 2 dicembre 2026 per i sistemi già sul mercato (il testo dell’articolo). È la direzione opposta a quella dei rilevatori: non indovinare se un testo è generato, ma dichiararlo alla fonte. Finché quella marcatura non sarà diffusa, la domanda «l’ha scritto un’IA?» resterà senza risposta affidabile — ed è meglio saperlo che credere a una percentuale.
In sintesi
I rilevatori di testo IA misurano la prevedibilità di un testo, non la sua origine: per questo sbagliano di sistema, e non per un difetto di taratura. I numeri lo dicono in modo netto — 61,22% di falsi positivi sui temi di studenti non madrelingua in uno studio su sette rilevatori, 26% di testi generati riconosciuti dal classificatore di OpenAI che è stato poi ritirato. Al posto di una percentuale servono le fonti, l’esperienza e il processo. E se l’accusa arriva a te, la difesa non è un altro rilevatore: è il tuo archivio di lavoro, più un dato pubblico che ti dà ragione.
Domande frequenti
- I rilevatori di IA sono affidabili?
- No. In uno studio del 2023 su sette rilevatori pubblici, il 61,22% dei temi scritti da persone non madrelingua inglese è stato classificato come generato dall’IA. Il classificatore di OpenAI riconosceva solo il 26% dei testi generati e segnalava il 9% dei testi umani, ed è stato ritirato nel luglio 2023 per la bassa accuratezza.
- Perché un testo scritto da me viene segnalato come IA?
- Perché il rilevatore misura quanto il testo è prevedibile, non chi l’ha scritto. Un testo formale, tradotto, tecnicamente regolare o molto lineare risulta «probabile» e viene segnato. È la ragione per cui i rilevatori segnalano anche testi classici scritti molto prima che l’IA generativa esistesse.
- Qual è il rilevatore IA più affidabile?
- Nessuno lo è in modo affidabile, e i dati disponibili non permettono una classifica: gli studi misurano tassi di errore alti su tutti gli strumenti testati, e i più diffusi sono tarati sull’inglese. Esistono rilevatori pensati per l’italiano, ma non ho trovato misurazioni indipendenti della loro accuratezza sull’italiano: chi promette numeri precisi sta inventando.
- Un rilevatore può essere usato come prova a scuola o al lavoro?
- No, ed è la raccomandazione più importante di questa pagina: uno strumento con oltre il 60% di falsi positivi su un gruppo di persone non è una prova, è un rischio per chi viene accusato. Se serve una verifica, si guarda il processo (versioni, appunti, bozze) e la sostanza (fonti, dati, esperienza).
- Cosa faccio se mi accusano di aver usato l'IA?
- Porta il processo, non un’altra percentuale: cronologia del documento, versioni precedenti, appunti, file di lavoro. E cita il dato pubblico: 61,22% di falsi positivi su testi umani in uno studio su sette rilevatori, e il ritiro del rilevatore di OpenAI per bassa accuratezza.
- Come si riconosce allora un testo generato dall'IA?
- Dalla sostanza, non dallo stile: le fonti citate che non esistono o non dicono quello che viene loro attribuito, i numeri che non tornano alla fonte, l’assenza di esperienza diretta. Sono controlli che richiedono di aprire i documenti, e sono gli unici che reggono.

Lascia un commento